落摔只有幾毫秒,模擬卻可能跑上一整晚。對結構分析工程師來說,真正拖慢研發的,往往不是少做了一張雲圖,而是來不及驗證下一個設計。
但縮短求解時間,並不等於買更多 CPU 核心,或加裝一張 GPU。顯式分析的效能,取決於模型、求解器版本、記憶體、平行化設定與工作流程的共同配合。只升級硬體,可能只是把原本的瓶頸搬到另一個地方。
對使用 SIMULIA Abaqus 的團隊而言,值得問的不是「哪台機器最快」,而是:如何在結果可信的前提下,用合理成本完成更多有效的設計驗證?
一、為什麼顯式分析這麼耗時?先理解時間增量的代價
Abaqus/Explicit 適合處理落摔、碰撞與衝擊等短時間、高度非線性的動態事件。顯式積分不需要像隱式分析一樣,在每個增量中進行全域平衡迭代,但必須受到穩定時間增量的限制。
從工程直覺理解,穩定時間增量可用下列關係近似描述:
穩定時間增量 Δt ≈ 元素特徵長度 L ÷ 材料膨脹波速 c。
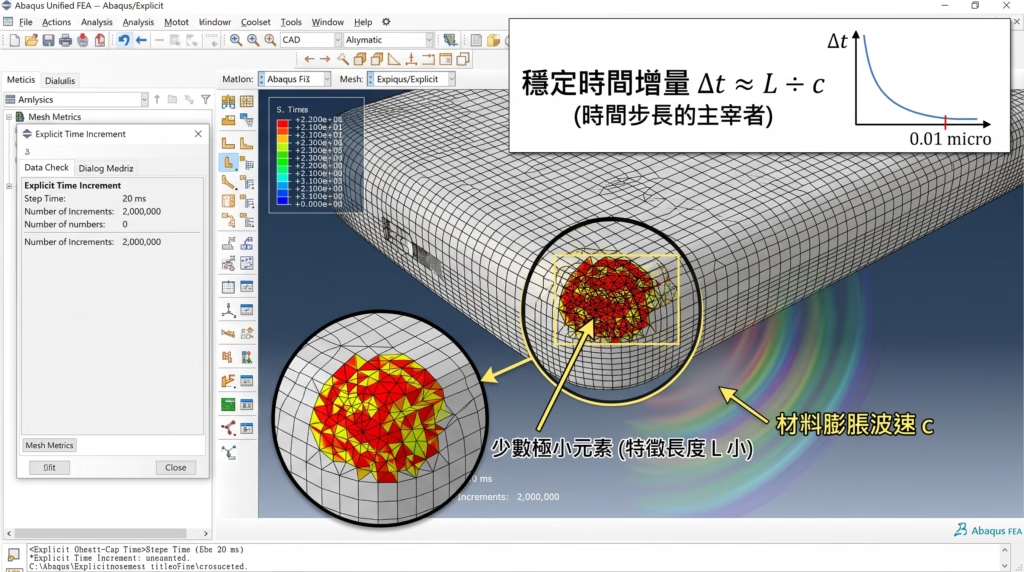
這不是所有元素與接觸條件下的完整公式,卻能說明一個常見現象:模型裡少數過小的元素,就可能拖慢整個分析。材料特性、元素形式、接觸剛性與變形狀態,也會影響實際穩定限制。
以單純的算術示意來說,若分析涵蓋 20 毫秒、平均時間增量為 0.1 微秒,就需要約 20 萬個增量;若增量再縮小為十分之一,增量數便增加到約 200 萬個。這只是計算量示例,並非特定產品的效能實測。
因此,運算成本至少要拆成兩個問題:
- 需要算幾次?受物理事件時長與穩定時間增量影響。
- 每次算多久?受元素與接觸計算、記憶體存取、通訊及輸出影響。
前者要從模型與分析設定改善,後者才是硬體與平行運算最佳化的主要戰場。
二、GPU 加速值得投入,但必須先確認版本與適用範圍
GPU 擅長大量平行運算,但「GPU 核心很多」不代表任何顯式模型都能直接加速。求解器是否支援、哪些計算可交由 GPU 執行,以及資料傳輸與未加速部分的占比,都會影響整體效益。
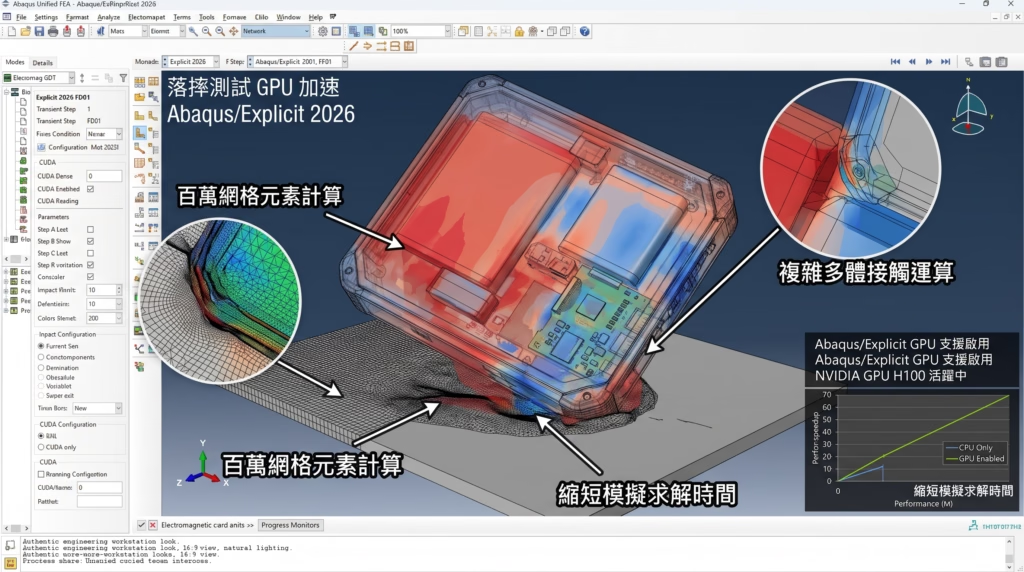
Abaqus/Explicit 的 GPU 支援尤其需要標明版本。SIMULIA Community 於 2026 年 1 月 23 日宣布,隨 2026 FD01 推出 Explicit 分析的 GPU 加速功能。這項更新不能反向套用到所有舊版 Abaqus,也不能與 Abaqus/Standard 的 GPU 加速能力混為一談。
對準備導入 GPU 的團隊,建議先完成三項確認:
- 確認軟體環境:核對實際安裝版本、更新層級,以及對應的硬體與驅動程式支援要求。
- 確認模型相容性:逐項檢查元素、材料、接觸與使用者副程式等設定,是否符合該版本的適用範圍。
- 確認端到端收益:以相同模型比較 CPU 與 GPU 配置,量測完整完成時間,而不是只看某段運算或 GPU 使用率。
GPU 也無法取代模型品質檢查。若瓶頸來自過小元素、過量輸出或跨節點通訊,增加 GPU 未必能解決問題。
因此,「從數天縮短到數小時」只能是特定測試條件下的結果,不能當成落摔分析的通用承諾。真正有意義的指標,是相同品質標準下,每個有效結果的時間與成本。
三、HPC 叢集不是核心越多越好:用公開數據看擴充效率
當單機資源不足,HPC 高效能運算叢集可透過 MPI 等機制,讓多個運算節點共同處理分析工作。但節點增加,也會增加資料交換、同步與等待的成本。
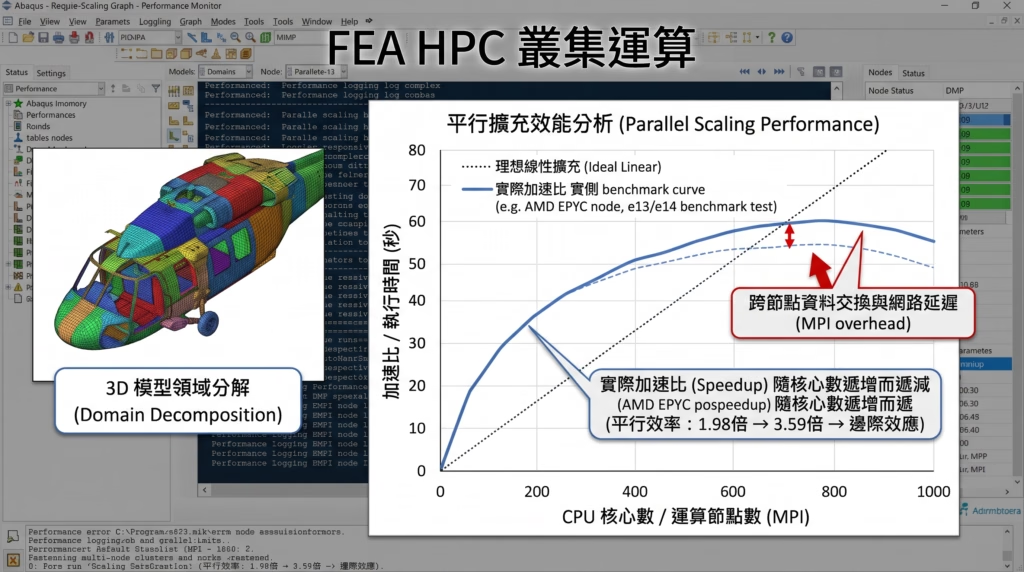
評估擴充性時,可以先掌握兩個指標:
- 加速比:基準配置的執行時間 ÷ 擴充後的執行時間。
- 平行效率:加速比 ÷ 相對於基準的資源增加倍數。
AMD 公開測試:四倍節點資源,約 3.59 倍加速
AMD 於 2021 年發布的 Abaqus/Explicit 技術簡報,以 Abaqus/Explicit 2021 R1 執行 e13 基準模型。測試採雙路 EPYC 75F3,每個節點共 64 個實體核心,搭配每節點 1 TB 記憶體與 200 Gb/s HDR InfiniBand 網路。
以單節點為基準:
- 2 個節點、128 核心:加速比約 1.98 倍。
- 4 個節點、256 核心:加速比約 3.59 倍。
換算後,平行效率分別約為 99% 與 90%。這代表該測試具有良好擴充性,也清楚顯示:資源增加四倍,執行速度不一定正好增加四倍。
這是硬體供應商在特定模型與配置下的測試,不是所有落摔模型的保證,更不是 GPU 加速數據。它的實務啟示在於:CPU 核心數、記憶體配置與節點互連必須一起評估。
NASA 研究:大幅加速可行,但不等於線性擴充
NASA 於 2019 年公開的技術報告,針對複合材料積層板漸進損傷分析,在五套 HPC 系統上測試 Abaqus/Explicit,涵蓋 16 至 512 個 CPU 核心。
報告指出,在其受測模型中,從 24 核心增加到 512 核心,可獲得約 10 至 15 倍加速。核心數增加約 21.3 倍,速度提升則低於這個倍數,說明大型分析能從 HPC 受益,但仍有擴充成本。
這項研究屬於複合材料分析,不能直接套用到消費性電子落摔。對企業更有價值的做法,是拿自己的代表模型,建立核心數與完成時間的曲線,找出效益開始明顯遞減的位置。
四、BMW 公開案例:真正的突破,往往來自模型與流程
如果硬體資源已經增加,速度卻沒有同步改善,接下來應該看什麼?BMW 工程師公開的〈How to improve performance of Abaqus/Explicit models〉,提供了具體方向。
同樣 200 核心,從約 28 小時降到約 12 小時
BMW 的整車碰撞案例包含約 1,050 萬個元素,模擬物理時間為 110 毫秒。
在 200 核心配置下,原始模型未啟用動態負載平衡時,完成時間為 28 小時 11 分 20 秒;採用兩倍領域數的動態負載平衡後,降為 22 小時 22 分 05 秒。
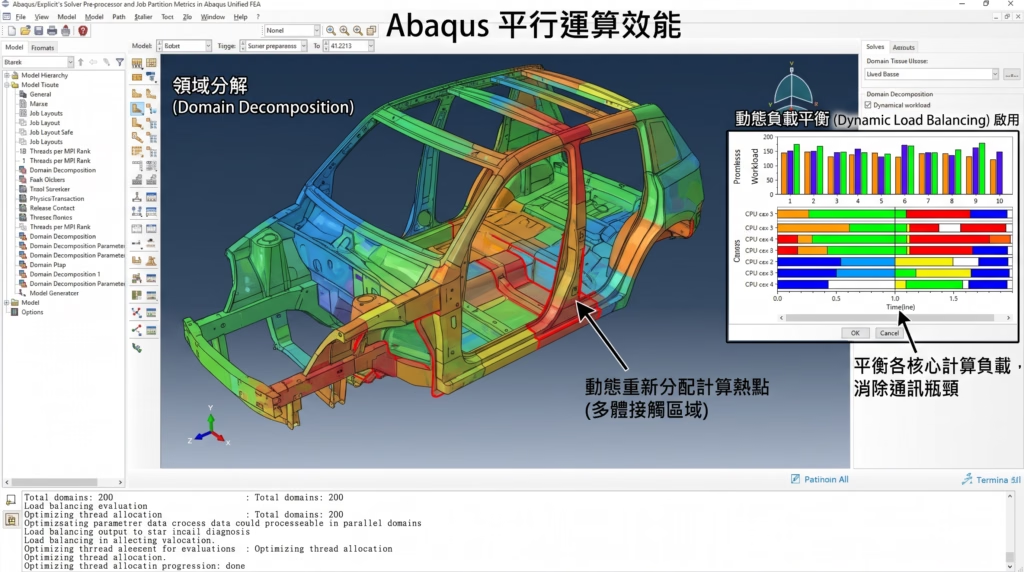
團隊進一步分析各領域的計算時間,辨識接觸計算熱點,修正特定建模問題並調整領域分解後,同為 200 核心的其中一項配置,完成時間降至 12 小時 11 分 48 秒。
這不是單一設定帶來的效果,而是效能剖析、模型修正與平行化調校的共同成果。其中涉及的特定效能問題,論文亦註明已於 Abaqus 2018 的維護版本修正;不應把當年的處理方式直接視為新版通用設定。
值得延續的是方法:先量測,再定位,最後調整,而不是先增加核心再期待問題消失。
多方案驗證時,「每件工作最快」未必最划算
同一篇論文也以行人頭部撞擊分析說明批次處理的價值。
在該 20 核心伺服器測試中,同時執行 4 件工作、每件分配 5 核心,相較於每件使用 20 核心、依序執行 4 件工作,使用的核心小時降至 72%,相當於減少約 28%。
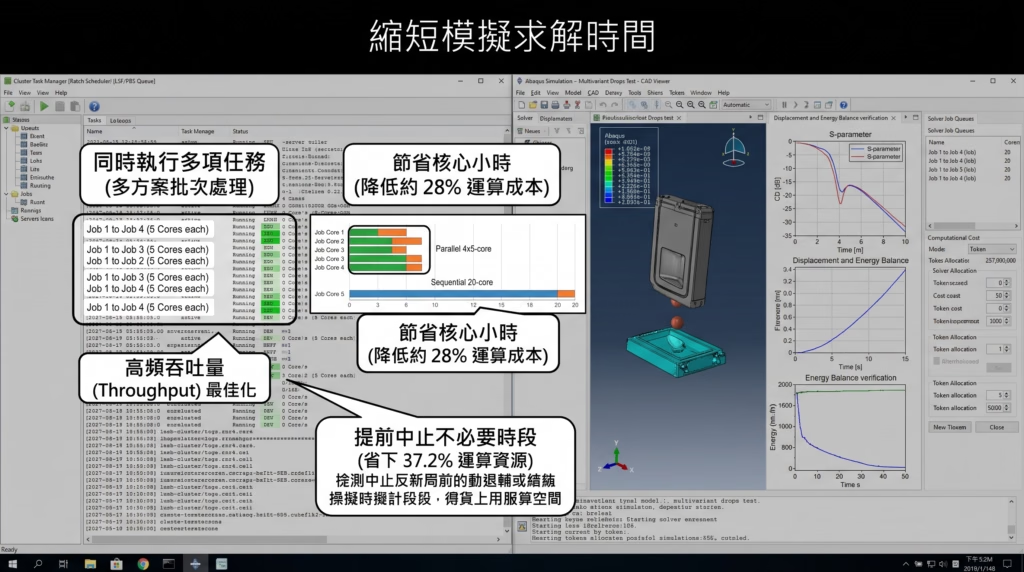
另一組包含 118 件工作的分析,透過監測撞擊與回彈行為,在保留足夠傷害指標評估資料的前提下,提早結束不再需要的模擬時段,將周轉時間與模擬資源使用量降低 37.2%。
對需要比較不同落摔方向、材料或結構方案的團隊而言,這個案例提醒我們:最佳化目標不一定是單件工作最快,而可能是整組設計方案最早完成。
五、如何發揮 Abaqus 平行運算效能?先做好四項基本功
1. 先找出限制時間增量的元素
檢查資料檢查與求解輸出中的穩定時間增量、關鍵元素及變形狀況。若少數細小或品質不佳的元素主導步長,應先判斷是否能調整幾何簡化與網格,而不是直接全面粗化。
**質量縮放也不是免費的加速。**它透過增加元素質量改善穩定時間增量,卻可能改變慣性與動態反應。尤其在落摔與衝擊問題中,應比較質量增加量、能量歷程、接觸力與關鍵變形,確認結果仍符合驗證需求。
2. 用領域分解與動態負載平衡處理計算熱點
領域分解將模型拆分成多個計算區域;動態負載平衡則可在分析過程中重新分配領域,改善不同核心間的工作量差異。
但它不能保證所有核心永遠滿載,也無法消除所有通訊瓶頸。領域切得更多,可能改善負載分配,也可能增加通訊與管理成本。是否啟用、領域數如何設定,都應以代表性模型測試。
3. 同時檢查記憶體、互連與輸出
CPU 核心需要持續取得資料才能有效工作。記憶體容量足夠,不代表頻寬與存取配置就一定合適;跨節點分析也需要檢視網路延遲與通訊負擔。
輸出設定同樣重要。落摔分析必須保留撞擊瞬間的關鍵資料,但過密、全模型的場輸出,也可能增加檔案容量與儲存負擔。
可依工程判讀需求,區分關鍵區域與整體輸出,並協調場輸出與歷程輸出的頻率。最佳化的前提是保留判斷失效與驗證模型所需的資訊,而不是單純縮小結果檔。
4. 把等待與後處理也算進去
工程師真正感受到的周轉時間,包含:
排隊等待+前處理與資料傳輸+求解+結果寫入+後處理。
一件使用更多核心、求解更快的工作,若必須等待更久才能取得資源,未必更早交付結果。因此,CAE 與 IT 團隊需要共同檢視單件工作的速度、整體吞吐量與授權使用情況。
六、從硬體採購走向可驗證的投資決策
導入 GPU 或擴充 HPC 前,建議先用實際落摔或碰撞模型建立小型評估:
- 固定比較條件:記錄軟體版本、模型、精度、接觸、時間增量控制與輸出設定。
- 建立 CPU 基準:測試不同核心數及節點數,記錄完成時間、核心小時與記憶體需求。
- 再評估 GPU:先確認版本與功能相容性,再比較端到端效能與使用成本。
- 比較單件與批次工作:確認資源集中於一件分析,或分配給多件分析,哪一種更符合研發需求。
- 驗證結果一致性:比較關鍵變形、接觸力、加速度及能量歷程,避免把數值品質的犧牲誤認為加速成果。
評估也不該只看採購價格。總持有成本還包含軟體授權、維運、電力、儲存與工程師等待時間;若使用雲端資源,則需納入運算、儲存與資料傳輸費用。
讓運算資源,真正轉化為更多設計驗證
打破顯式分析的成本高牆,不是 CPU、GPU 與 HPC 的單選題,而是讓模型、求解器與運算架構各自發揮作用。
GPU 為符合條件的 Abaqus/Explicit 分析帶來新的加速途徑;HPC 叢集支援更大規模的平行運算;模型與流程最佳化,則能減少不必要的計算與等待。
真正值得追求的,不只是更快得到一份結果,而是在相同預算與時程內,完成更多可信的設計比較。
若您的團隊正在評估 Abaqus/Explicit 升級、GPU 導入或 HPC 擴充,不妨先從一個具代表性的模型開始,與 SIMULIA 技術團隊討論版本相容性、效能量測與結果驗證,讓投資建立在可重現的工程證據上。